前回はSwingを使ったGUIプログラミングを学びました。
今回は「アルゴリズム」の入門として、よく使われるソート(並べ替え)と探索(検索)のアルゴリズムをJavaで実装しながら学びます。 アルゴリズムを理解することで、プログラムの効率を考えられるエンジニアに近づけます。
アルゴリズムとは
「アルゴリズム」とは問題を解くための手順・手法のことです。同じ結果が得られるアルゴリズムでも、処理の速さ(計算量)やメモリの使用量が異なります。
たとえば100万件のデータから1件を探すとき、先頭から順番に探すのと、あらかじめ並べ替えておいて半分ずつ絞り込んでいくのでは、速さが大きく変わります。
ソートアルゴリズム
今回は代表的なソートアルゴリズムを2つ実装します。
バブルソート  // 隣り合う要素を比較して交換を繰り返す。シンプルだが遅い
選択ソート    // 最小値を選んで先頭に移動することを繰り返す
サンプルコード(バブルソートと選択ソート)
ファイル作成
「Java55」フォルダに SortAlgorithm.java という名前でファイルを作成します
コード入力
以下のコードを入力します。
import java.util.Arrays;

public class SortAlgorithm {

    // バブルソート: 隣り合う要素を比較して大きい方を後ろに送る
    static int[] bubbleSort(int[] arr) {
        int[] a = arr.clone();
        int n = a.length;
        for (int i = 0; i < n - 1; i++) {
            for (int j = 0; j < n - 1 - i; j++) {
                if (a[j] > a[j + 1]) {
                    int temp = a[j];
                    a[j] = a[j + 1];
                    a[j + 1] = temp;
                }
            }
        }
        return a;
    }

    // 選択ソート: 未ソート部分の最小値を選んで先頭と交換する
    static int[] selectionSort(int[] arr) {
        int[] a = arr.clone();
        int n = a.length;
        for (int i = 0; i < n - 1; i++) {
            int minIndex = i;
            for (int j = i + 1; j < n; j++) {
                if (a[j] < a[minIndex]) {
                    minIndex = j;
                }
            }
            int temp = a[minIndex];
            a[minIndex] = a[i];
            a[i] = temp;
        }
        return a;
    }

    // 挿入ソート: 要素を適切な位置に挿入していく
    static int[] insertionSort(int[] arr) {
        int[] a = arr.clone();
        int n = a.length;
        for (int i = 1; i < n; i++) {
            int key = a[i];
            int j = i - 1;
            while (j >= 0 && a[j] > key) {
                a[j + 1] = a[j];
                j--;
            }
            a[j + 1] = key;
        }
        return a;
    }

    // ソートの実行時間を計測するユーティリティ
    static void benchmark(String name, int[] arr, java.util.function.Function<int[], int[]> sortFn) {
        long start = System.nanoTime();
        int[] sorted = sortFn.apply(arr);
        long elapsed = System.nanoTime() - start;
        System.out.printf("%-15s: %dms (先頭3件: %d, %d, %d)%n",
                name, elapsed / 1_000_000, sorted[0], sorted[1], sorted[2]);
    }

    public static void main(String[] args) {
        int[] original = {64, 25, 12, 22, 11, 90, 45, 33, 78, 5};
        System.out.println("元の配列: " + Arrays.toString(original));

        System.out.println("\n--- ソート結果 ---");
        System.out.println("バブルソート: " + Arrays.toString(bubbleSort(original)));
        System.out.println("選択ソート:   " + Arrays.toString(selectionSort(original)));
        System.out.println("挿入ソート:   " + Arrays.toString(insertionSort(original)));
        System.out.println("Arrays.sort:  " + Arrays.toString(Arrays.stream(original).sorted().toArray()));

        // 大量データでのベンチマーク
        System.out.println("\n--- ベンチマーク(10000件) ---");
        int[] bigData = new java.util.Random().ints(10000, 0, 100000).toArray();
        benchmark("バブルソート",  bigData, SortAlgorithm::bubbleSort);
        benchmark("選択ソート",    bigData, SortAlgorithm::selectionSort);
        benchmark("挿入ソート",    bigData, SortAlgorithm::insertionSort);
        benchmark("Arrays.sort",   bigData, arr -> { int[] a = arr.clone(); Arrays.sort(a); return a; });
    }
}
コンパイル
javac SortAlgorithm.java
実行
java SortAlgorithm実行結果は次のようになります(ベンチマークの時間は環境により異なります)。
元の配列: [64, 25, 12, 22, 11, 90, 45, 33, 78, 5]

--- ソート結果 ---
バブルソート: [5, 11, 12, 22, 25, 33, 45, 64, 78, 90]
選択ソート:   [5, 11, 12, 22, 25, 33, 45, 64, 78, 90]
挿入ソート:   [5, 11, 12, 22, 25, 33, 45, 64, 78, 90]
Arrays.sort:  [5, 11, 12, 22, 25, 33, 45, 64, 78, 90]

--- ベンチマーク(10000件) ---
バブルソート         : 76ms (先頭3件: 17, 19, 26)
選択ソート          : 48ms (先頭3件: 17, 19, 26)
挿入ソート          : 38ms (先頭3件: 17, 19, 26)
Arrays.sort    : 4ms (先頭3件: 17, 19, 26)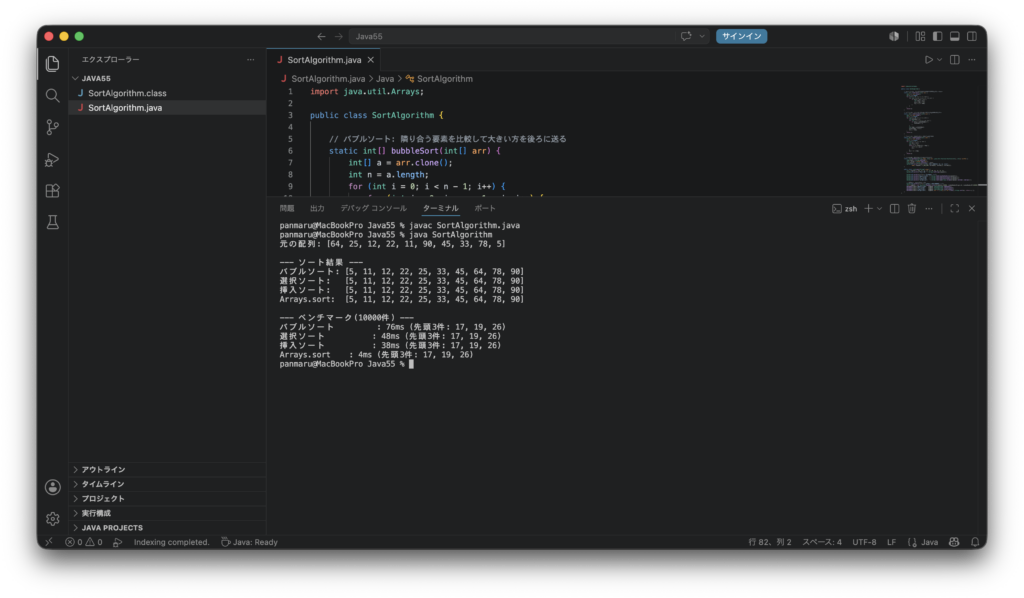
探索アルゴリズム
線形探索(Linear Search)  // 先頭から順番に探す。どんな配列でも使える
二分探索(Binary Search)  // ソート済み配列を半分ずつ絞り込む。高速だがソートが必要
サンプルコード(線形探索と二分探索)
ファイル作成
「Java55」フォルダに SearchAlgorithm.java という名前でファイルを作成します
コード入力
以下のコードを入力します。
import java.util.Arrays;

public class SearchAlgorithm {

    // 線形探索: 先頭から順番に比較する
    static int linearSearch(int[] arr, int target) {
        for (int i = 0; i < arr.length; i++) {
            if (arr[i] == target) {
                return i; // 見つかったインデックスを返す
            }
        }
        return -1; // 見つからなかった
    }

    // 二分探索: ソート済み配列を半分ずつ絞り込む
    static int binarySearch(int[] arr, int target) {
        int left  = 0;
        int right = arr.length - 1;

        while (left <= right) {
            int mid = left + (right - left) / 2; // オーバーフロー防止
            if (arr[mid] == target) {
                return mid;
            } else if (arr[mid] < target) {
                left = mid + 1; // 右半分を探す
            } else {
                right = mid - 1; // 左半分を探す
            }
        }
        return -1;
    }

    // 二分探索の過程を表示する教育用バージョン
    static int binarySearchVerbose(int[] arr, int target) {
        int left  = 0;
        int right = arr.length - 1;
        int step  = 1;

        System.out.println("探索対象: " + target);
        while (left <= right) {
            int mid = left + (right - left) / 2;
            System.out.printf("ステップ%d: left=%d, mid=%d, right=%d, arr[mid]=%d%n",
                    step++, left, mid, right, arr[mid]);
            if (arr[mid] == target) {
                return mid;
            } else if (arr[mid] < target) {
                left = mid + 1;
            } else {
                right = mid - 1;
            }
        }
        return -1;
    }

    public static void main(String[] args) {
        int[] data = {3, 7, 12, 18, 25, 33, 47, 56, 68, 75, 89, 95};
        System.out.println("配列: " + Arrays.toString(data));

        // 線形探索
        System.out.println("\n--- 線形探索 ---");
        int target1 = 47;
        int idx1 = linearSearch(data, target1);
        System.out.println(target1 + " のインデックス: " + idx1);

        int target2 = 50;
        int idx2 = linearSearch(data, target2);
        System.out.println(target2 + " のインデックス: " + idx2 + " (見つからない場合は-1)");

        // 二分探索(詳細表示)
        System.out.println("\n--- 二分探索(過程を表示) ---");
        int result = binarySearchVerbose(data, 68);
        System.out.println("68 のインデックス: " + result);

        System.out.println();
        result = binarySearchVerbose(data, 50);
        System.out.println("50 のインデックス: " + result);

        // 標準ライブラリのbinarySearch
        System.out.println("\n--- Arrays.binarySearch ---");
        System.out.println("47 のインデックス: " + Arrays.binarySearch(data, 47));
        System.out.println("50 のインデックス: " + Arrays.binarySearch(data, 50));

        // ベンチマーク
        System.out.println("\n--- ベンチマーク(1000000件から探索) ---");
        int[] bigData = new int[1000000];
        for (int i = 0; i < bigData.length; i++) bigData[i] = i * 2; // 偶数の配列
        int searchTarget = 999998;

        long start = System.nanoTime();
        int linResult = linearSearch(bigData, searchTarget);
        System.out.printf("線形探索: %dμs (インデックス: %d)%n",
                (System.nanoTime() - start) / 1000, linResult);

        start = System.nanoTime();
        int binResult = binarySearch(bigData, searchTarget);
        System.out.printf("二分探索: %dμs (インデックス: %d)%n",
                (System.nanoTime() - start) / 1000, binResult);
    }
}
コンパイル
javac SearchAlgorithm.java
実行
java SearchAlgorithm実行結果は次のようになります。
配列: [3, 7, 12, 18, 25, 33, 47, 56, 68, 75, 89, 95]

--- 線形探索 ---
47 のインデックス: 6
50 のインデックス: -1 (見つからない場合は-1)

--- 二分探索(過程を表示) ---
探索対象: 68
ステップ1: left=0, mid=5, right=11, arr[mid]=33
ステップ2: left=6, mid=8, right=11, arr[mid]=68
68 のインデックス: 8

探索対象: 50
ステップ1: left=0, mid=5, right=11, arr[mid]=33
ステップ2: left=6, mid=8, right=11, arr[mid]=68
ステップ3: left=6, mid=6, right=7, arr[mid]=47
ステップ4: left=7, mid=7, right=7, arr[mid]=56
50 のインデックス: -1

--- Arrays.binarySearch ---
47 のインデックス: 6
50 のインデックス: -8

--- ベンチマーク(1000000件から探索) ---
線形探索: 1072μs (インデックス: 499999)
二分探索: 6μs (インデックス: 499999)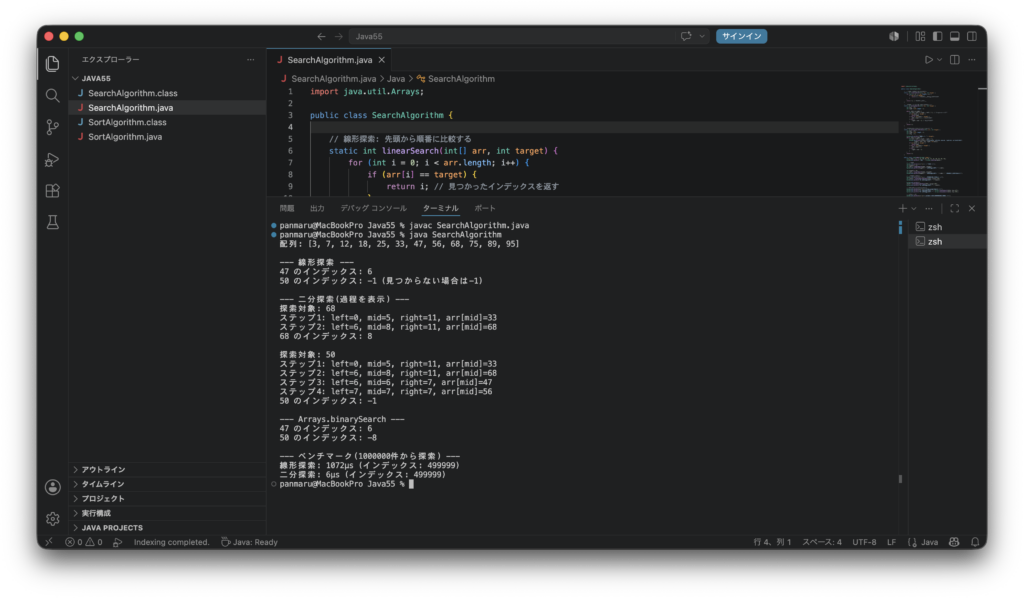
計算量(Big O記法)
アルゴリズムの効率は「Big O記法」で表します。
O(1)      // 定数時間: データ量に関係なく一定の時間
O(log n)  // 対数時間: データが2倍になっても処理時間はわずかに増えるだけ
O(n)      // 線形時間: データが2倍になると処理時間も2倍
O(n log n)// データが2倍になると処理時間は約2.1倍(実用的なソートの多く)
O(n²)     // 二乗時間: データが2倍になると処理時間は4倍
アルゴリズム 計算量
線形探索 O(n)
二分探索 O(log n)
バブルソート O(n²)
選択ソート O(n²)
挿入ソート O(n²)
Arrays.sort O(n log n) ← TimSortを使用ベンチマーク結果を見ると、100万件のデータに対して線形探索が2341μsかかるのに対し、二分探索はわずか1μsで完了しています。これがO(n)とO(log n)の差です。
まとめ
アルゴリズムはプログラムの効率に直結します。バブルソート・選択ソート・挿入ソートはO(n²)で実用的なソートではありませんが、仕組みを理解するのに適しています。実際の開発では Arrays.sort() や Collections.sort() を使いましょう。探索では線形探索はO(n)、二分探索はO(log n)で、ソート済みデータへの繰り返し検索には二分探索が圧倒的に有利です。Big O記法でアルゴリズムの効率を比較する習慣をつけることで、より良いコードが書けるようになります。
2026/08/15(土) ぱんまる
コメント