前回はPriorityQueueを学びました。
今回は「TreeMap」と「TreeSet」について解説します。前回学んだ二分探索木をベースにした標準クラスで、データを自動的にソートした状態で管理できます。
TreeMapとTreeSetとは
HashMap  → 順番なし・高速
TreeMap  → キーが自動ソート・やや低速

HashSet  → 順番なし・高速
TreeSet  → 自動ソート・やや低速
「挿入した順番より、常にソートされた状態で扱いたい」場面でTreeMap・TreeSetが活躍します。
サンプルコード
ファイル作成
「Java60」フォルダに TreeMapSetTest.java という名前でファイルを作成します
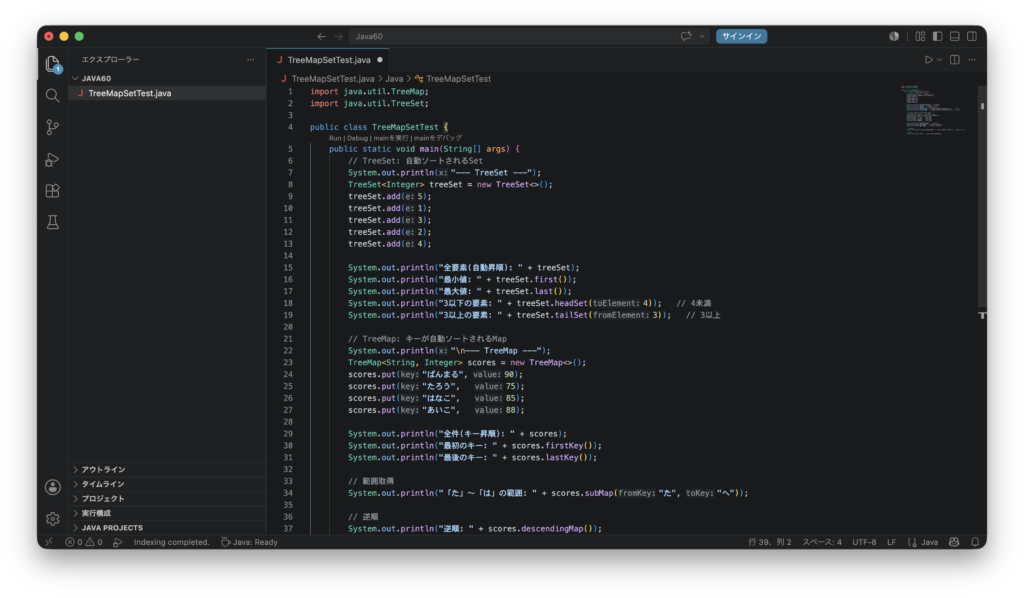
コード入力
import java.util.TreeMap;
import java.util.TreeSet;

public class TreeMapSetTest {
    public static void main(String[] args) {
        // TreeSet: 自動ソートされるSet
        System.out.println("--- TreeSet ---");
        TreeSet<Integer> treeSet = new TreeSet<>();
        treeSet.add(5);
        treeSet.add(1);
        treeSet.add(3);
        treeSet.add(2);
        treeSet.add(4);

        System.out.println("全要素(自動昇順): " + treeSet);
        System.out.println("最小値: " + treeSet.first());
        System.out.println("最大値: " + treeSet.last());
        System.out.println("3以下の要素: " + treeSet.headSet(4));   // 4未満
        System.out.println("3以上の要素: " + treeSet.tailSet(3));   // 3以上

        // TreeMap: キーが自動ソートされるMap
        System.out.println("\n--- TreeMap ---");
        TreeMap<String, Integer> scores = new TreeMap<>();
        scores.put("ぱんまる", 90);
        scores.put("たろう",   75);
        scores.put("はなこ",   85);
        scores.put("あいこ",   88);

        System.out.println("全件(キー昇順): " + scores);
        System.out.println("最初のキー: " + scores.firstKey());
        System.out.println("最後のキー: " + scores.lastKey());

        // 範囲取得
        System.out.println("「た」〜「は」の範囲: " + scores.subMap("た", "へ"));

        // 逆順
        System.out.println("逆順: " + scores.descendingMap());
    }
}
コンパイル
javac TreeMapSetTest.java
実行
java TreeMapSetTest実行結果は次のようになります。
--- TreeSet ---
全要素(自動昇順): [1, 2, 3, 4, 5]
最小値: 1
最大値: 5
3以下の要素: [1, 2, 3]
3以上の要素: [3, 4, 5]

--- TreeMap ---
全件(キー昇順): {あいこ=88, たろう=75, はなこ=85, ぱんまる=90}
最初のキー: あいこ
最後のキー: ぱんまる
「た」〜「は」の範囲: {たろう=75}
逆順: {ぱんまる=90, はなこ=85, たろう=75, あいこ=88}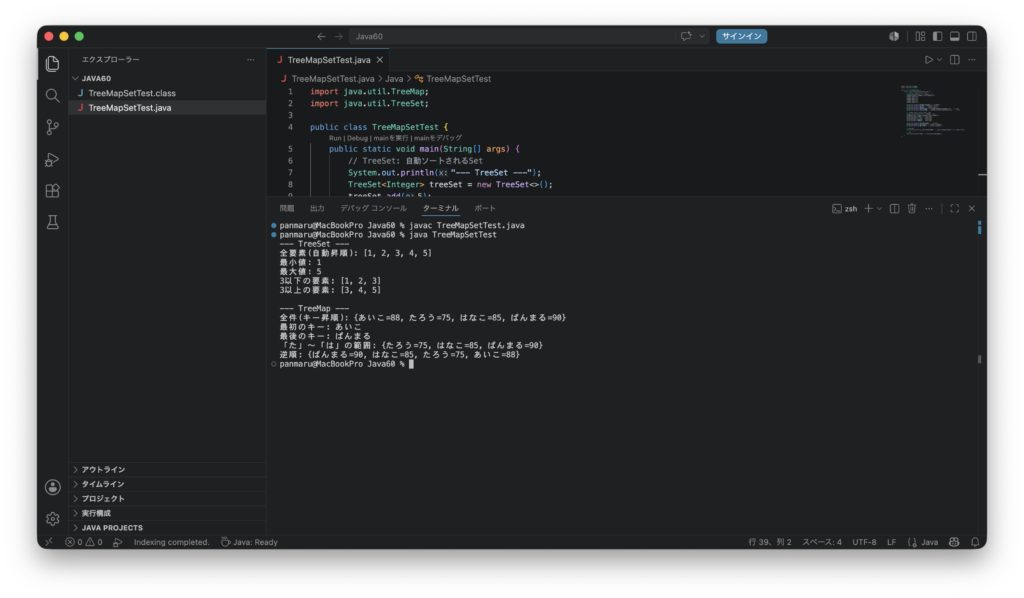
まとめ
TreeMapとTreeSetはデータを常にソートされた状態で管理したいときに使います。first()・last() で最小・最大を取得でき、headSet()・tailSet()・subMap() で範囲を指定した取得もできます。順番を気にしない場合はHashMap・HashSetの方が高速なので、用途に応じて使い分けましょう。
2026/08/20(木) ぱんまる
コメント