前回はキューを学びました。
今回はデータ構造入門の最終回「二分探索木」です。
二分探索木とは
二分探索木(BST: Binary Search Tree)は、各ノードが「左の子 < 自分 < 右の子」というルールで値を持つ木構造です。このルールのおかげで効率的な検索・挿入・昇順取り出しができます。
サンプルコード
ファイル作成
「Java58」フォルダに BSTSample.java という名前でファイルを作成します
コード入力
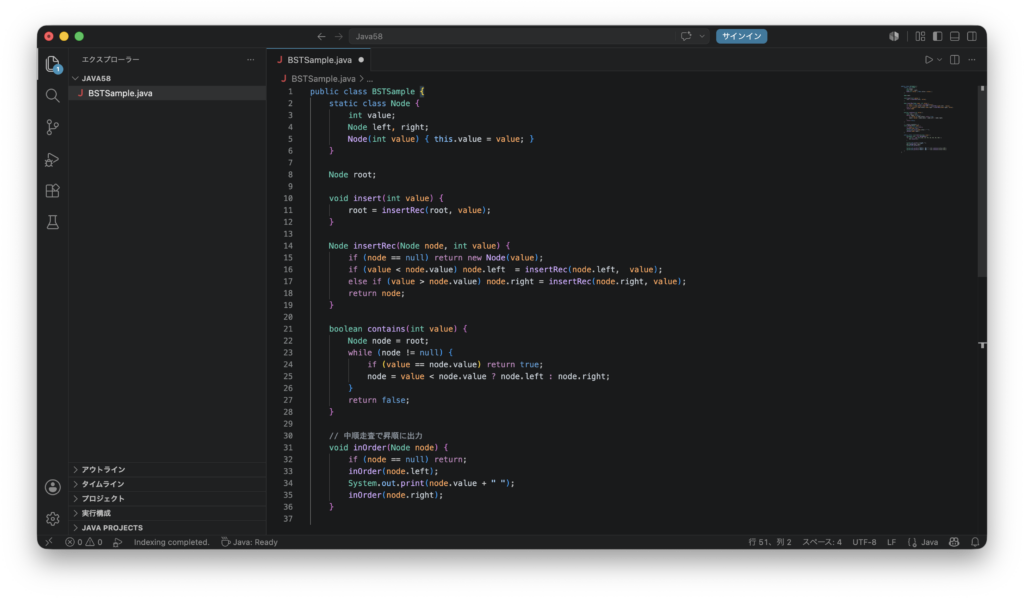
public class BSTSample {
    static class Node {
        int value;
        Node left, right;
        Node(int value) { this.value = value; }
    }

    Node root;

    void insert(int value) {
        root = insertRec(root, value);
    }

    Node insertRec(Node node, int value) {
        if (node == null) return new Node(value);
        if (value < node.value) node.left  = insertRec(node.left,  value);
        else if (value > node.value) node.right = insertRec(node.right, value);
        return node;
    }

    boolean contains(int value) {
        Node node = root;
        while (node != null) {
            if (value == node.value) return true;
            node = value < node.value ? node.left : node.right;
        }
        return false;
    }

    // 中順走査で昇順に出力
    void inOrder(Node node) {
        if (node == null) return;
        inOrder(node.left);
        System.out.print(node.value + " ");
        inOrder(node.right);
    }

    public static void main(String[] args) {
        BSTSample bst = new BSTSample();
        for (int v : new int[]{50, 30, 70, 20, 40, 60, 80}) {
            bst.insert(v);
        }

        System.out.print("昇順: ");
        bst.inOrder(bst.root);
        System.out.println();

        System.out.println("40を含む?: " + bst.contains(40));
        System.out.println("45を含む?: " + bst.contains(45));
    }
}
コンパイル
javac BSTSample.java
実行
java BSTSample実行結果は次のようになります。
昇順: 20 30 40 50 60 70 80
40を含む?: true
45を含む?: false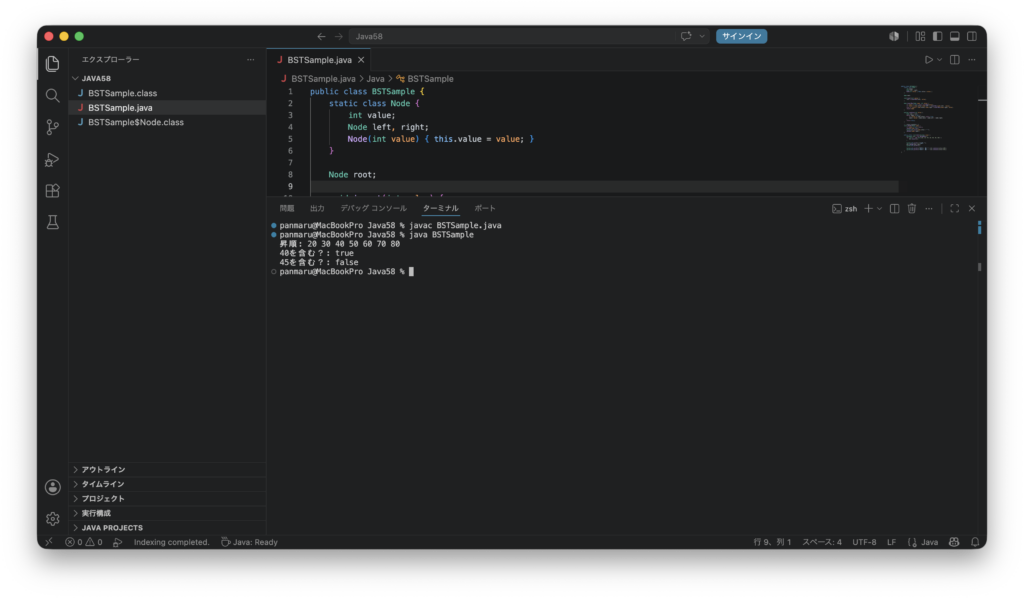
木構造のイメージ
        50
       /  \
      30   70
     / \  / \
    20 40 60 80
検索は「目標より小さければ左、大きければ右」と進むためO(log n)の効率で動作します。
まとめ
二分探索木はデータを階層構造で管理し、検索・挿入がO(log n)で効率的に行えます。中順走査で昇順にデータを取り出せる点も特徴です。実際の開発では TreeMap や TreeSet がBSTをベースにした標準クラスとして提供されています。これでデータ構造入門(スタック・キュー・二分探索木)の3回シリーズが完了です!
2026/08/18(火) ぱんまる
コメント